Mis à jour le 18 octobre 2026
Le 15 octobre 2026, Meta a ouvert les poids de Muse Spark Open, un modèle de 816 milliards de paramètres destiné à la programmation et aux agents IA. Avec Apple, l’entreprise a optimisé son exécution locale sur des Mac Studio équipés du M5 Ultra. La configuration officielle exige deux Mac Studio de 512 Go ou quatre de 256 Go. Apple annonce la version de 512 Go pour fin octobre, sans prix communiqué. Des API tierces permettent déjà de découvrir le modèle sans posséder son propre cluster.
- Le modèle de Meta compte 816 milliards de paramètres, dont 42 milliards actifs par token. Son contexte atteint 1 million de tokens et il accepte texte, images, vidéo et audio.
- Apple a préparé l’exécution avec MLX et mlx-lm 0.32.1, les échanges RDMA via Thunderbolt 5 et une présentation dans son blog Apple Machine Learning Research.
- Matériel officiel : 2 × 512 Go ou 4 × 256 Go. Le budget dépend des configurations ; les versions de 512 Go sont annoncées pour fin octobre, sans tarif communiqué.
- Apple mesure 24,99 tokens/s sur deux Mac et 36,73 tokens/s sur quatre, avec une répartition tensorielle du modèle.
- La Muse Model License autorise l’utilisation gratuite avec la mention « Built with Muse Spark Open ». Un seuil de chiffre d’affaires de 20 millions de dollars s’applique aux services API ; les usages militaires sont interdits.
- La licence n’exclut aucun pays. L’accès aux poids officiels nécessite une validation manuelle de la demande ; cela ne garantit pas l’acceptation de chaque dossier.
- Les annonces de Meta et Apple du 15 octobre
- Muse Spark Open : 816 milliards de paramètres et un contexte immense
- Benchmarks : ses points forts face aux modèles chinois
- Pourquoi le Mac Studio M5 Ultra et sa mémoire unifiée ?
- MLX et RDMA via Thunderbolt 5 : le travail d’Apple
- Quel budget pour deux Mac Studio, quatre ou une API ?
- Sur un Mac classique : Muse Glimmer, LM Studio et Ollama
- Apple et Meta : des tensions autour du suivi publicitaire au partenariat
- Télécharger et utiliser Muse Spark Open en France
- Questions fréquentes
- À lire également
- Conclusion
Les annonces de Meta et Apple du 15 octobre
Meta a présenté Muse Spark Open dans son blog de recherche le 15 octobre. L’entreprise la décrit comme le modèle américain à poids ouverts le plus performant à cette date. Cette appréciation vient de Meta : les résultats de ses propres tests et l’indice indépendant d’Artificial Analysis, présentés plus bas, permettent de la mettre en perspective.
Sur X, Mark Zuckerberg a annoncé la publication des poids le jour même et remercié John Ternus ainsi qu’Apple pour le travail effectué sur les nouveaux Mac Studio. Le directeur général d’Apple a souligné la possibilité d’exécuter un tel modèle directement depuis son bureau. Apple détaille la partie technique dans son blog Apple Machine Learning Research. L’annonce figure également sur le blog développeurs de Meta et celui de PyTorch. Les espaces presse des deux entreprises ne comportent pas de publication distincte consacrée à cette sortie.
Selon CNBC, la préparation a demandé plusieurs mois. Alexandr Wang, qui dirige l’IA chez Meta, a plaisanté auprès d’Axios en se réjouissant que « papa et maman s’entendent à nouveau », une déclaration relayée par MacRumors et 9to5Mac. D’après Axios, Daniel Gross, ancien dirigeant d’Apple désormais chez Meta, a joué un rôle clé dans ce rapprochement. Les deux entreprises ont refusé de préciser si cette coopération aurait une suite.
Muse Spark Open : 816 milliards de paramètres et un contexte de 1 million de tokens
Muse Spark Open est un grand modèle de langage, ou LLM, développé par Meta Superintelligence Labs. Ses poids, les réglages numériques nécessaires aux calculs, peuvent être téléchargés pour une utilisation locale. Son architecture Mixture-of-Experts, ou « mélange d’experts », comporte 256 blocs spécialisés, mais n’en sollicite que 8 pour chaque token. Sur les 816 milliards de paramètres, 42 milliards sont donc actifs à la fois. Il faut conserver l’ensemble du modèle en mémoire, tout en ne mobilisant qu’une partie de ses paramètres pour les calculs.
Meta annonce une fenêtre de contexte de 1 million de tokens : elle correspond à la quantité de contenu que le modèle peut traiter dans une requête. Il accepte texte, images, vidéo et audio, et produit des réponses textuelles. Les possibilités d’un service donné peuvent être plus restreintes : Groq propose un contexte de 131 072 tokens et accepte le texte et les images. Selon Hugging Face, le raisonnement ne peut pas être désactivé. Quatre niveaux sont proposés, low, medium, high et xhigh, ce dernier étant sélectionné par défaut.
Pour les tâches confiées aux agents, Meta a présenté Muse Code utilisant ce modèle pour corriger l’application iOS Ice Cubes et piloter le logiciel de montage DaVinci Resolve. Il s’agit de démonstrations de l’entreprise. La base est la Muse Spark d’août, complétée par un entraînement de sécurité. Artificial Analysis attribue un indice de 39 à cette version ouverte, contre 48 pour la Muse Spark 1.3 fermée et 52 pour Muse Wonder. Alexandr Wang a reconnu auprès de CNBC que ces modèles n’étaient pas les plus performants développés ou publiés par Meta.
L’expression open-weight désigne ici des poids ouverts sous une licence propre, la Muse Model License. Celle-ci autorise gratuitement l’utilisation, la modification, l’entraînement complémentaire et la redistribution, à condition de joindre la licence et la mention « Built with Muse Spark Open ». Les entreprises fournissant des modèles à des tiers par API doivent conclure un accord distinct avec Meta avant de lancer ce service si leur chiffre d’affaires cumulé avec celui de leurs sociétés liées dépasse 20 millions de dollars sur 12 mois consécutifs. La politique d’utilisation exclut les moins de 18 ans. L’assistant personnel Muse de Meta constitue un produit séparé. Pour le modèle lui-même, Meta annonce un entraînement sur plus de 100 langues, sans détailler ici la qualité obtenue dans chacune.
Benchmarks de Muse Spark Open : ses points forts et ses limites face aux modèles chinois
Meta compare son nouveau modèle aux américains Inkling, Nemotron 3 Ultra et Beam, au français Mistral Large 4 ainsi qu’aux chinois Qwen3.8, GLM 5.3 et Kimi K3. Les scores ci-dessous proviennent du tableau de Meta. Pour certains modèles concurrents, l’entreprise reprend les résultats publiés par leurs développeurs.
| Benchmark | Compétence évaluée | Muse Spark Open | Qwen3.8 | GLM 5.3 | Kimi K3 |
|---|---|---|---|---|---|
| Indice Artificial Analysis | Capacités intellectuelles générales du modèle | 39 | 40 | 45 | 44 |
| JobBench | Exécution de tâches complexes par des agents | 61.8 | 52.7 | 61.4 | 54.3 |
| MCP-Atlas | Utilisation d’outils MCP | 89.2 | 84.5 | 84.2 | 82.3 |
| HLE-Diamond sans outils | Questions difficiles sans recherche | 26.1 | 17.3 | 16.4 | 22.2 |
| AA-Omniscience | Exactitude des connaissances, sans inventions | 25 | 4 | 14 | 20 |
| SciCode | Programmation pour des tâches scientifiques | 58.5 | 54.1 | 59.0 | 59.5 |
| Terminal-Bench 2.1 | Exécution de tâches dans le terminal | 76.4 | 82.0 | 83.9 | 85.0 |
| DeepSWE 1.1 | Correction d’erreurs dans le code | 60 | 57 | 67 | 68 |
Dans ce tableau, Muse Spark Open arrive en tête sur JobBench, MCP-Atlas, HLE-Diamond et AA-Omniscience : ces tests portent sur les tâches des agents, les outils, les questions complexes et les connaissances sans inventions. Le tableau plus large de Meta la place également en première position sur certains tests multimodaux, dont SimpleVQA et IntPhys2. Elle ne domine toutefois pas la programmation : Kimi K3 et GLM 5.3 la dépassent dans SciCode, et l’écart leur est également favorable dans Terminal-Bench et DeepSWE.
Les trois modèles chinois de ce tableau devancent Muse Spark Open dans l’indice général d’Artificial Analysis. Ce service indépendant confirme le score de 39 et juge l’API coûteuse parmi les modèles ouverts de taille comparable. DeepSeek, gpt-oss, GPT, Claude et Gemini ne figurent pas dans la comparaison de Meta.
Pourquoi le Mac Studio M5 Ultra : 512 Go de mémoire unifiée et 1,2 To/s
Le Mac Studio se prête à cette expérience grâce à sa mémoire unifiée. Le processeur et la partie graphique partagent la même réserve : le GPU du M5 Ultra peut ainsi accéder à 512 Go. Selon Apple, les poids de Muse Spark Open en BF16 occupent plus de 1,6 To. La quantification NVFP4 réduit la précision des nombres et leur encombrement : Meta évoque environ 530 Go, Apple environ 493 Go. Avec la mémoire nécessaire aux calculs, la version officielle ne tient pas dans une seule machine, explique Apple.
Selon notre calcul, les seuls poids numériques, sans données supplémentaires, représentent 816 milliards × 2 octets = 1 632 Go en 16 bits, ou 816 milliards × 0,5 octet = 408 Go en 4 bits. Les fichiers réels sont plus volumineux à cause des métadonnées et des couches conservées à une précision supérieure. La bande passante de 1,2 To/s concerne, elle, une seule puce M5 Ultra. Selon Meta, elle suffit pour lire la partie active du modèle, soit 42 milliards de paramètres par token.
Le M5 Ultra réunit deux M5 Max par UltraFusion. Sa configuration supérieure associe un CPU à 36 cœurs et un GPU à 80 cœurs, avec des Neural Accelerators dans les cœurs graphiques. Notre comparatif des puces M6 et M5 Ultra détaille cette architecture. Le Mac Studio a été annoncé le 25 août et commercialisé le 22 septembre 2026. Apple réserve l’option 512 Go à la puce supérieure et la promet pour fin octobre. Les tests utilisent précisément ces machines encore indisponibles à l’achat.
En mars 2025, Apple avait présenté le M3 Ultra avec une option de 512 Go, en évoquant des modèles de plus de 600 milliards de paramètres entièrement en mémoire. Cette option a été retirée début mars 2026, selon Cult of Mac, heise et Notebookcheck. Pour Muse Spark Open, Apple publie désormais les mesures suivantes sur M5 Ultra, en NVFP4, avec une génération de 128 tokens.
| Configuration | Génération, tokens/s (contexte 8 192) | Génération, tokens/s (contexte 65 536) | Premier token, s (8 192) | Premier token, s (65 536) |
|---|---|---|---|---|
| 2 Mac, pipeline | 15,74 | 14,37 | 8,4 | 47,6 |
| 2 Mac, tensoriel | 24,99 | 23,84 | 8,2 | 70,3 |
| 4 Mac, tensoriel | 36,73 | 34,66 | 4,8 | 40,6 |
Le mode pipeline répartit les couches successives entre les machines. Le mode tensoriel partage le travail à l’intérieur de chaque couche. D’après notre calcul, en mode tensoriel avec le contexte le plus court, générer une réponse de 1 000 tokens prendrait environ 40 secondes sur deux Mac ou 27 secondes sur quatre, soit respectivement 1 000 / 24,99 et 1 000 / 36,73. Il faut ajouter le délai avant le premier token indiqué dans le tableau. Meta ne publie pas ses propres mesures de vitesse.
MLX et RDMA via Thunderbolt 5 : ce qu’Apple a préparé
MLX est le framework ouvert d’Apple pour l’apprentissage automatique, disponible publiquement depuis décembre 2023 sous licence MIT. Il fournit des outils de calcul pour Apple silicon et tient compte de la mémoire unifiée. La prise en charge de Muse Spark Open apparaît dans le paquet mlx-lm 0.32.1 du 15 octobre 2026. Cette partie logicielle permet de répartir le grand modèle entre plusieurs ordinateurs.
RDMA permet aux Mac d’échanger directement des données en mémoire via Thunderbolt 5 avec une faible latence. Apple a introduit cette possibilité dans macOS Tahoe 26.2, sorti le 12 décembre 2025. L’activation s’effectue en mode de récupération avec la commande rdma_ctl enable, avant de redémarrer le Mac. Dans MLX, les échanges reposent sur JACCL, disponible depuis la version 0.30.1 du 18 décembre 2025.
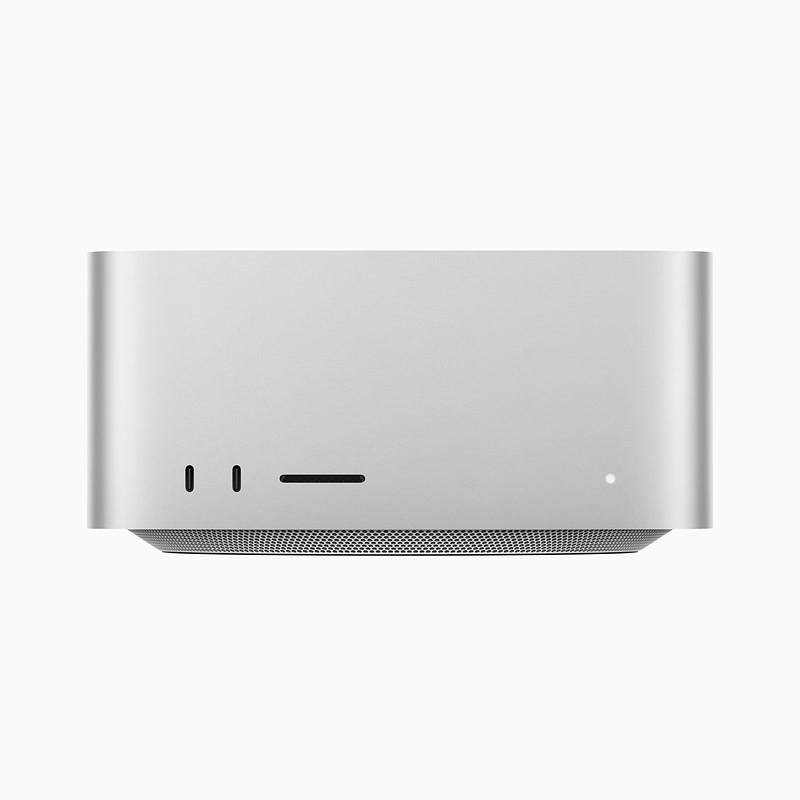
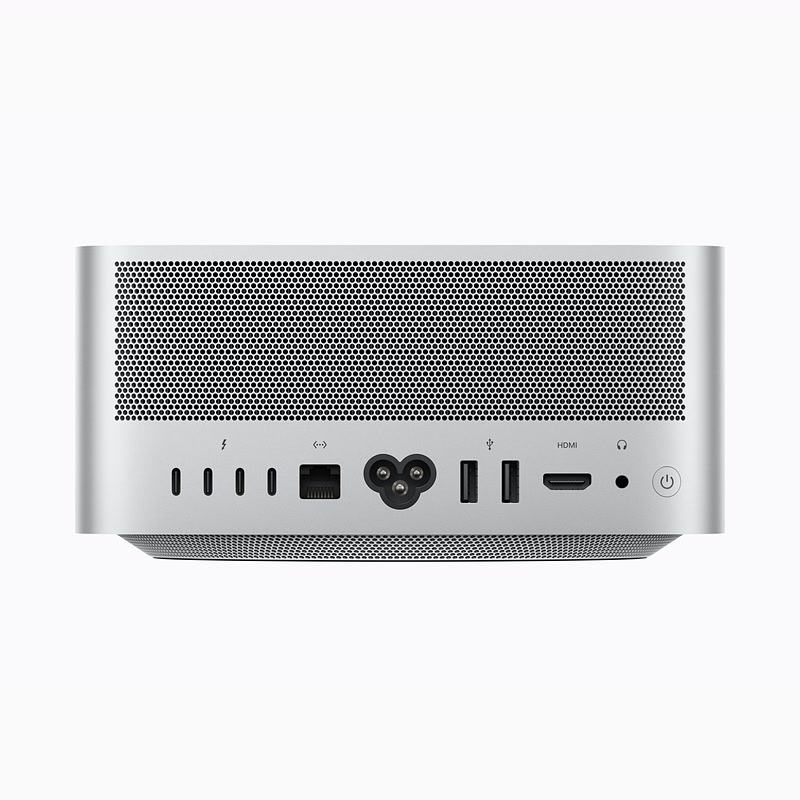
Chaque paire de Mac doit être reliée directement par câble. Apple a testé deux câbles par paire ; la prise en charge du second a été ajoutée dans MLX 0.32.4 du 14 octobre 2026. Le Mac Studio M5 Ultra possède 6 ports Thunderbolt 5, dont 4 à l’arrière et 2 en façade.
Le guide de Meta exige macOS 26.2 ou une version ultérieure, MLX 0.30.1 ou une version ultérieure, et assez d’espace disque sur chaque Mac pour conserver l’intégralité des poids NVFP4. Le paquet mlx-lm 0.32.1 requiert pour sa part MLX 0.32.2 ou une version ultérieure. Meta estime la configuration à environ 4 heures. L’annonce distincte d’Apple d’une accélération pouvant atteindre 3× sur quatre Mac concerne un modèle de 72 milliards de paramètres, et non Muse.
Quel budget pour Muse Spark Open : deux Mac Studio, quatre ou une API ?
Pour une exécution locale, le principal poste de dépense est la mémoire des ordinateurs. La configuration de départ annoncée aux États-Unis ne possède que 96 Go et un SSD de 1 To : le scénario officiel de Meta impose davantage de mémoire. Les montants américains des versions de 256 Go ci-dessous proviennent de médias spécialisés, notamment Notebookcheck et Invide Labs. Aucun montant n’est encore annoncé pour 512 Go. Ces références en dollars ne constituent pas des tarifs français.
| Solution | Matériel ou service nécessaire | Prix (États-Unis, au 16 octobre 2026) | Vitesse et limites |
|---|---|---|---|
| Deux Mac Studio M5 Ultra de 512 Go | Puces CPU/GPU 36/80 ; liaison Thunderbolt 5 | Prix non annoncé par Apple ; commercialisation fin octobre | Apple : 24,99 tokens/s en tensoriel ou 15,74 tokens/s en pipeline |
| Quatre Mac Studio M5 Ultra de 256 Go | Puces de base 30/64 ou supérieures 36/80 | Dès $37 996 selon notre calcul ; $43 196 avec la puce supérieure | Apple : 36,73 tokens/s sur quatre Mac de test de 512 Go ; aucune mesure distincte pour 4 × 256 Go |
| API de fournisseurs tiers | OpenRouter, Together AI, Groq, Fireworks AI, Baseten, Modal, Nebius | OpenRouter / Together AI : $1,25 par 1 million de tokens en entrée et $4,25 par 1 million en sortie | Groq : environ 350+ tokens/s, contexte 131 072 ; Fireworks AI : accès limité jusqu’au 29 octobre 2026 |
| Un seul Mac Studio de 512 Go, solution non officielle | Version communautaire en 3 bits, environ 359–370 Go | Prix du nouveau M5 Ultra de 512 Go inconnu ; scénario HF testé sur M3 Ultra | Hugging Face : environ 21 tokens/s sur M3 Ultra ; scénario non annoncé par Apple et Meta ; compatibilité avec mlx-lm officiel non vérifiée |
Les estimations américaines montrent surtout l’ampleur de l’investissement : il faut plusieurs machines fortement dotées en mémoire, auxquelles s’ajoutent écrans, câbles et éventuelles taxes. Faute de prix officiel en euros confirmé dans les éléments fournis, nous ne proposons pas de conversion pour la France. Pour comparer une offre locale chez les revendeurs, il faut retenir la configuration exacte de la puce et la quantité de mémoire, plutôt que le seul prix de départ du Mac Studio.
Une API donne accès au modèle sur les serveurs d’un prestataire, avec une facturation selon le volume traité. OpenRouter et Together AI proposent aussi un tarif réduit pour les tokens d’entrée mis en cache. Le coût d’une requête dépend donc des tokens envoyés, de ceux générés et du cache éventuel. Cette solution permet d’essayer le modèle sans financer le matériel nécessaire à son exécution locale. Muse Spark Open ne figure pas dans Meta Model API ; Ollama le propose uniquement dans le cloud.
Que lancer sur un Mac classique : Muse Glimmer, LM Studio et Ollama
Muse Spark Open ne tient pas sur un MacBook, un iMac ou un Mac mini : même la plus petite version tierce occupe environ 176 Go. Pour un Mac classique, Meta propose Muse Glimmer, un modèle de 30 milliards de paramètres publié le 10 août 2026 sous licence Apache 2.0. Il s’agit d’un modèle distillé à partir de Muse Spark fermée : le plus petit a été entraîné à partir du plus grand. Selon Meta, la partie linguistique de Glimmer occupe moins de 20 Go en 4 bits.
LM Studio offre une interface de chat et une exécution locale gratuite pour un usage personnel ou professionnel. MLX est pris en charge depuis la version 0.3.4. Un Mac Apple silicon et macOS 14 ou une version ultérieure sont nécessaires ; au moins 16 Go de mémoire sont recommandés. Muse Spark Open ne figure pas au catalogue. La licence de LM Studio est propriétaire, tandis que le code de son moteur MLX est ouvert.
Ollama est distribué sous licence MIT et exige également macOS 14 ou une version ultérieure. Sur Apple silicon, depuis la version 0.40 à l’automne 2026, les modèles d’architectures compatibles utilisent MLX par défaut ; les autres passent par llama.cpp. Glimmer se lance avec ollama run muse-glimmer. Pour travailler dans le terminal, mlx-lm s’installe avec pip install mlx-lm et nécessite Python 3.11 ou une version ultérieure. Le tableau suivant aide à choisir une taille de modèle : il présente notre interprétation des données des développeurs et des mesures d’Apple.
| Mémoire du Mac | Modèles envisageables | Fichier / mémoire (données des développeurs) |
|---|---|---|
| 16 Go | Qwen3-8B / Qwen3-14B, 4 bits ; gpt-oss-20b de justesse | Apple : 5,6 / 9,2 Go ; gpt-oss : minimum 12 Go dans LM Studio, fichier de 14 Go dans Ollama |
| 24 Go | Qwen3-30B-A3B, 4 bits ; Qwen3-8B, BF16 ; Muse Glimmer à la limite | Apple : 17,31 / 17,46 Go ; Meta propose Glimmer pour 24 Go, LM Studio indique au moins 26 Go |
| 32 Go | Muse Glimmer ; Qwen3-32B ; Qwen3.8-27B ; DeepSeek-R1-Distill 32B, 4 bits | Ollama : 18–19 Go ; 20 Go ; 18 Go ; 20 Go respectivement |
| 64 Go | Qwen3.8-27B / Muse Glimmer, 8 bits ; DeepSeek-R1-Distill-Llama-70B, 4 bits | Ollama : 30 / 31 / 43 Go respectivement |
| 96–128 Go | gpt-oss-120b ; Qwen3.8-27B, BF16 avec contexte long | LM Studio / Ollama : 65 Go ; Apple : jusqu’à 68 Go respectivement |
La taille du téléchargement ne correspond pas à toute la mémoire nécessaire. Le contexte, macOS et les applications ouvertes occupent aussi de la place. D’après notre calcul, des poids en 4 bits représentent environ 0,6 Go par milliard de paramètres, auxquels il faut ajouter cette marge. Glimmer sur un Mac de 24 Go illustre bien la difficulté : Meta propose une version compressée adaptée, mais LM Studio indique un minimum de 26 Go pour son fichier. Nous considérons donc ce lancement comme à la limite des capacités d’un Mac de 24 Go ; avec 32 Go, le choix devient plus simple.
Apple et Meta : des tensions sur le suivi publicitaire au lancement commun
App Tracking Transparency est arrivé dans iOS 14.5 le 26 avril 2021 : les applications ont dû demander l’autorisation de suivre les utilisateurs. En février 2022, Dave Wehner, directeur financier de Meta, estimait à environ 10 milliards de dollars la perte de chiffre d’affaires pour l’année. Il s’agissait de l’évaluation par Meta des conséquences des changements d’Apple.
Mark Zuckerberg critiquait déjà Apple le 27 janvier 2021, en la présentant comme un concurrent majeur. Le 10 janvier 2025, dans le podcast de Joe Rogan, il lui reprochait à nouveau un manque d’innovations importantes. Selon un article du WSJ du 23 juin 2024, les deux groupes avaient discuté d’une intégration de Llama à Apple Intelligence. Le lendemain, Bloomberg précisait qu’Apple avait décliné après de brefs contacts. Cette intégration n’a finalement pas eu lieu.
En 2026, le partenaire d’Apple pour les modèles est Google Gemini : la coopération a été annoncée le 12 janvier, puis Apple a décrit des modèles développés ensemble à la WWDC du 8 juin. Muse Spark Open reste une création de Meta. Apple fournit MLX et les outils permettant son exécution distribuée.
La direction d’Apple a également changé : John Ternus est directeur général depuis le 1er septembre 2026. Avant sa nomination, il avait passé 25 ans dans l’entreprise et dirigeait l’ingénierie matérielle. Tim Cook est désormais président exécutif du conseil d’administration. C’est Ternus qui a publiquement félicité l’équipe à l’occasion de Muse Spark Open.
Auprès de CNBC, Alexandr Wang a expliqué que l’essentiel de l’animosité remontait à une période antérieure à son arrivée. Les entreprises ne communiquent pas sur d’éventuels prochains accords.
Peut-on télécharger et utiliser Muse Spark Open en France ?
La Muse Model License ne prévoit pas de pays exclus. Sur Hugging Face, l’accès aux poids officiels dépend d’une validation manuelle. Le formulaire recueille le nom, la date de naissance, le pays, l’organisation, le poste et la géolocalisation associée à l’adresse IP. Les critères de sélection ne sont pas publics : l’absence d’exclusion géographique ne garantit donc pas l’acceptation d’une demande française. Les versions communautaires sont téléchargeables sans demande préalable, sous la même licence. Après téléchargement, le modèle fonctionne hors ligne sans clé API.
Les éléments fournis ne permettent pas de confirmer séparément les conditions d’accès depuis la France à chaque API tierce. La présence des serveurs de Fireworks AI aux États-Unis ne détermine pas, à elle seule, le pays des clients acceptés. La politique d’utilisation interdit les usages militaires à tous les utilisateurs, quel que soit leur pays. Les règles de téléchargement des poids doivent par ailleurs être distinguées de celles de l’assistant Muse, qui est un autre produit.
Meta annonce un entraînement dans plus de 100 langues, sans fournir ici de résultats spécifiques au français. Cela ne permet pas de conclure à un niveau de qualité identique dans toutes les langues. La prise en charge linguistique d’Apple Intelligence relève également d’un service distinct : elle ne détermine pas les langues utilisables avec Muse Spark Open exécuté localement.
Questions fréquentes
Qu’est-ce que Muse Spark Open ?
Il s’agit d’un modèle de Meta Superintelligence Labs de 816 milliards de paramètres, dont les poids ont été ouverts le 15 octobre 2026. Destiné à la programmation et aux tâches des agents, il produit des réponses textuelles.
Peut-on lancer Muse Spark Open sur un seul Mac ?
Officiellement, non : pour la version NVFP4, Meta indique deux Mac Studio de 512 Go ou quatre de 256 Go. Hugging Face a toutefois exécuté une version communautaire compressée oQ3e sur un seul Mac Studio M3 Ultra de 512 Go, avec environ 21 tokens/s en génération.
Combien coûte le Mac Studio M5 Ultra de 512 Go ?
Apple n’a pas encore annoncé le prix de la configuration de 512 Go et prévoit sa commercialisation pour fin octobre. Cette capacité sera réservée à la puce avec CPU à 36 cœurs et GPU à 80 cœurs.
Muse Spark Open est-il gratuit ?
Oui, la Muse Model License autorise l’utilisation gratuite sous conditions, dont l’ajout de la mention « Built with Muse Spark Open ». Les entreprises fournissant à des tiers un accès API à des modèles IA doivent conclure un accord distinct avec Meta avant le lancement du service si leur chiffre d’affaires cumulé avec celui de leurs sociétés liées dépasse 20 millions de dollars sur une période quelconque de 12 mois consécutifs.
Qu’est-ce que MLX d’Apple ?
C’est un framework d’apprentissage automatique pour Apple silicon, sous licence MIT, public depuis décembre 2023. Muse Spark Open est pris en charge dans mlx-lm 0.32.1 ; l’exécution distribuée utilise RDMA et Thunderbolt 5.
Quelle différence avec Muse Spark et Muse Wonder ?
Il s’agit d’une version à poids ouverts fondée sur la Muse Spark d’août, avec un entraînement de sécurité supplémentaire. Artificial Analysis lui attribue 39 points, contre 48 pour la Muse Spark 1.3 fermée et 52 pour Muse Wonder.
Peut-on télécharger Muse Spark Open en France ?
Les versions communautaires sont accessibles sans demande préalable et la licence du 15 octobre 2026 n’exclut aucun pays. Les dépôts officiels nécessitent une validation manuelle ; les éléments fournis ne permettent pas de garantir l’acceptation d’un dossier français.
Quel modèle IA peut-on lancer sur un Mac classique ?
Sur un Mac de 32 Go, Muse Glimmer est envisageable : selon le développeur, les fichiers d’Ollama occupent 18–19 Go. Pour 16 Go, notre point de départ est Qwen3-8B ou Qwen3-14B en 4 bits, avec une marge pour le système et le contexte.
À lire également
- Meta Muse : les possibilités de l’agent IA personnel de Meta — pour comprendre la différence entre un assistant prêt à l’emploi et un modèle à exécuter soi-même.
- Gemini 4 Argon : le modèle de Google, Fairwind et les prix API — pour comparer les approches de l’accès dans le cloud.
- OpenAI DevDay 2026 : dots, GPT-6.1 Sol et toutes les annonces — pour situer les outils utilisés par les développeurs.
- Jev de TypeSafe AI : un modèle IA pour les développeurs — pour prolonger le sujet des modèles consacrés au code.
Conclusion
Meta et Apple proposent une méthode officielle pour exécuter Muse Spark Open sur un bureau, à condition d’y réunir plusieurs Mac Studio. Ce scénario s’adresse aujourd’hui aux développeurs qui ont besoin d’une exécution locale et disposent d’un budget conséquent. Les API permettent de découvrir le modèle, tandis que des modèles plus petits conviennent à un Mac classique. La prochaine étape annoncée par Apple est l’arrivée de la configuration de 512 Go fin octobre, à un prix encore inconnu. Retrouvez les autres développements dans notre rubrique consacrée à l’intelligence artificielle.